Odchylenie standardowe w Excelu – jak obliczyć i interpretować?
Czym jest odchylenie standardowe i jak je obliczyć w Excelu?
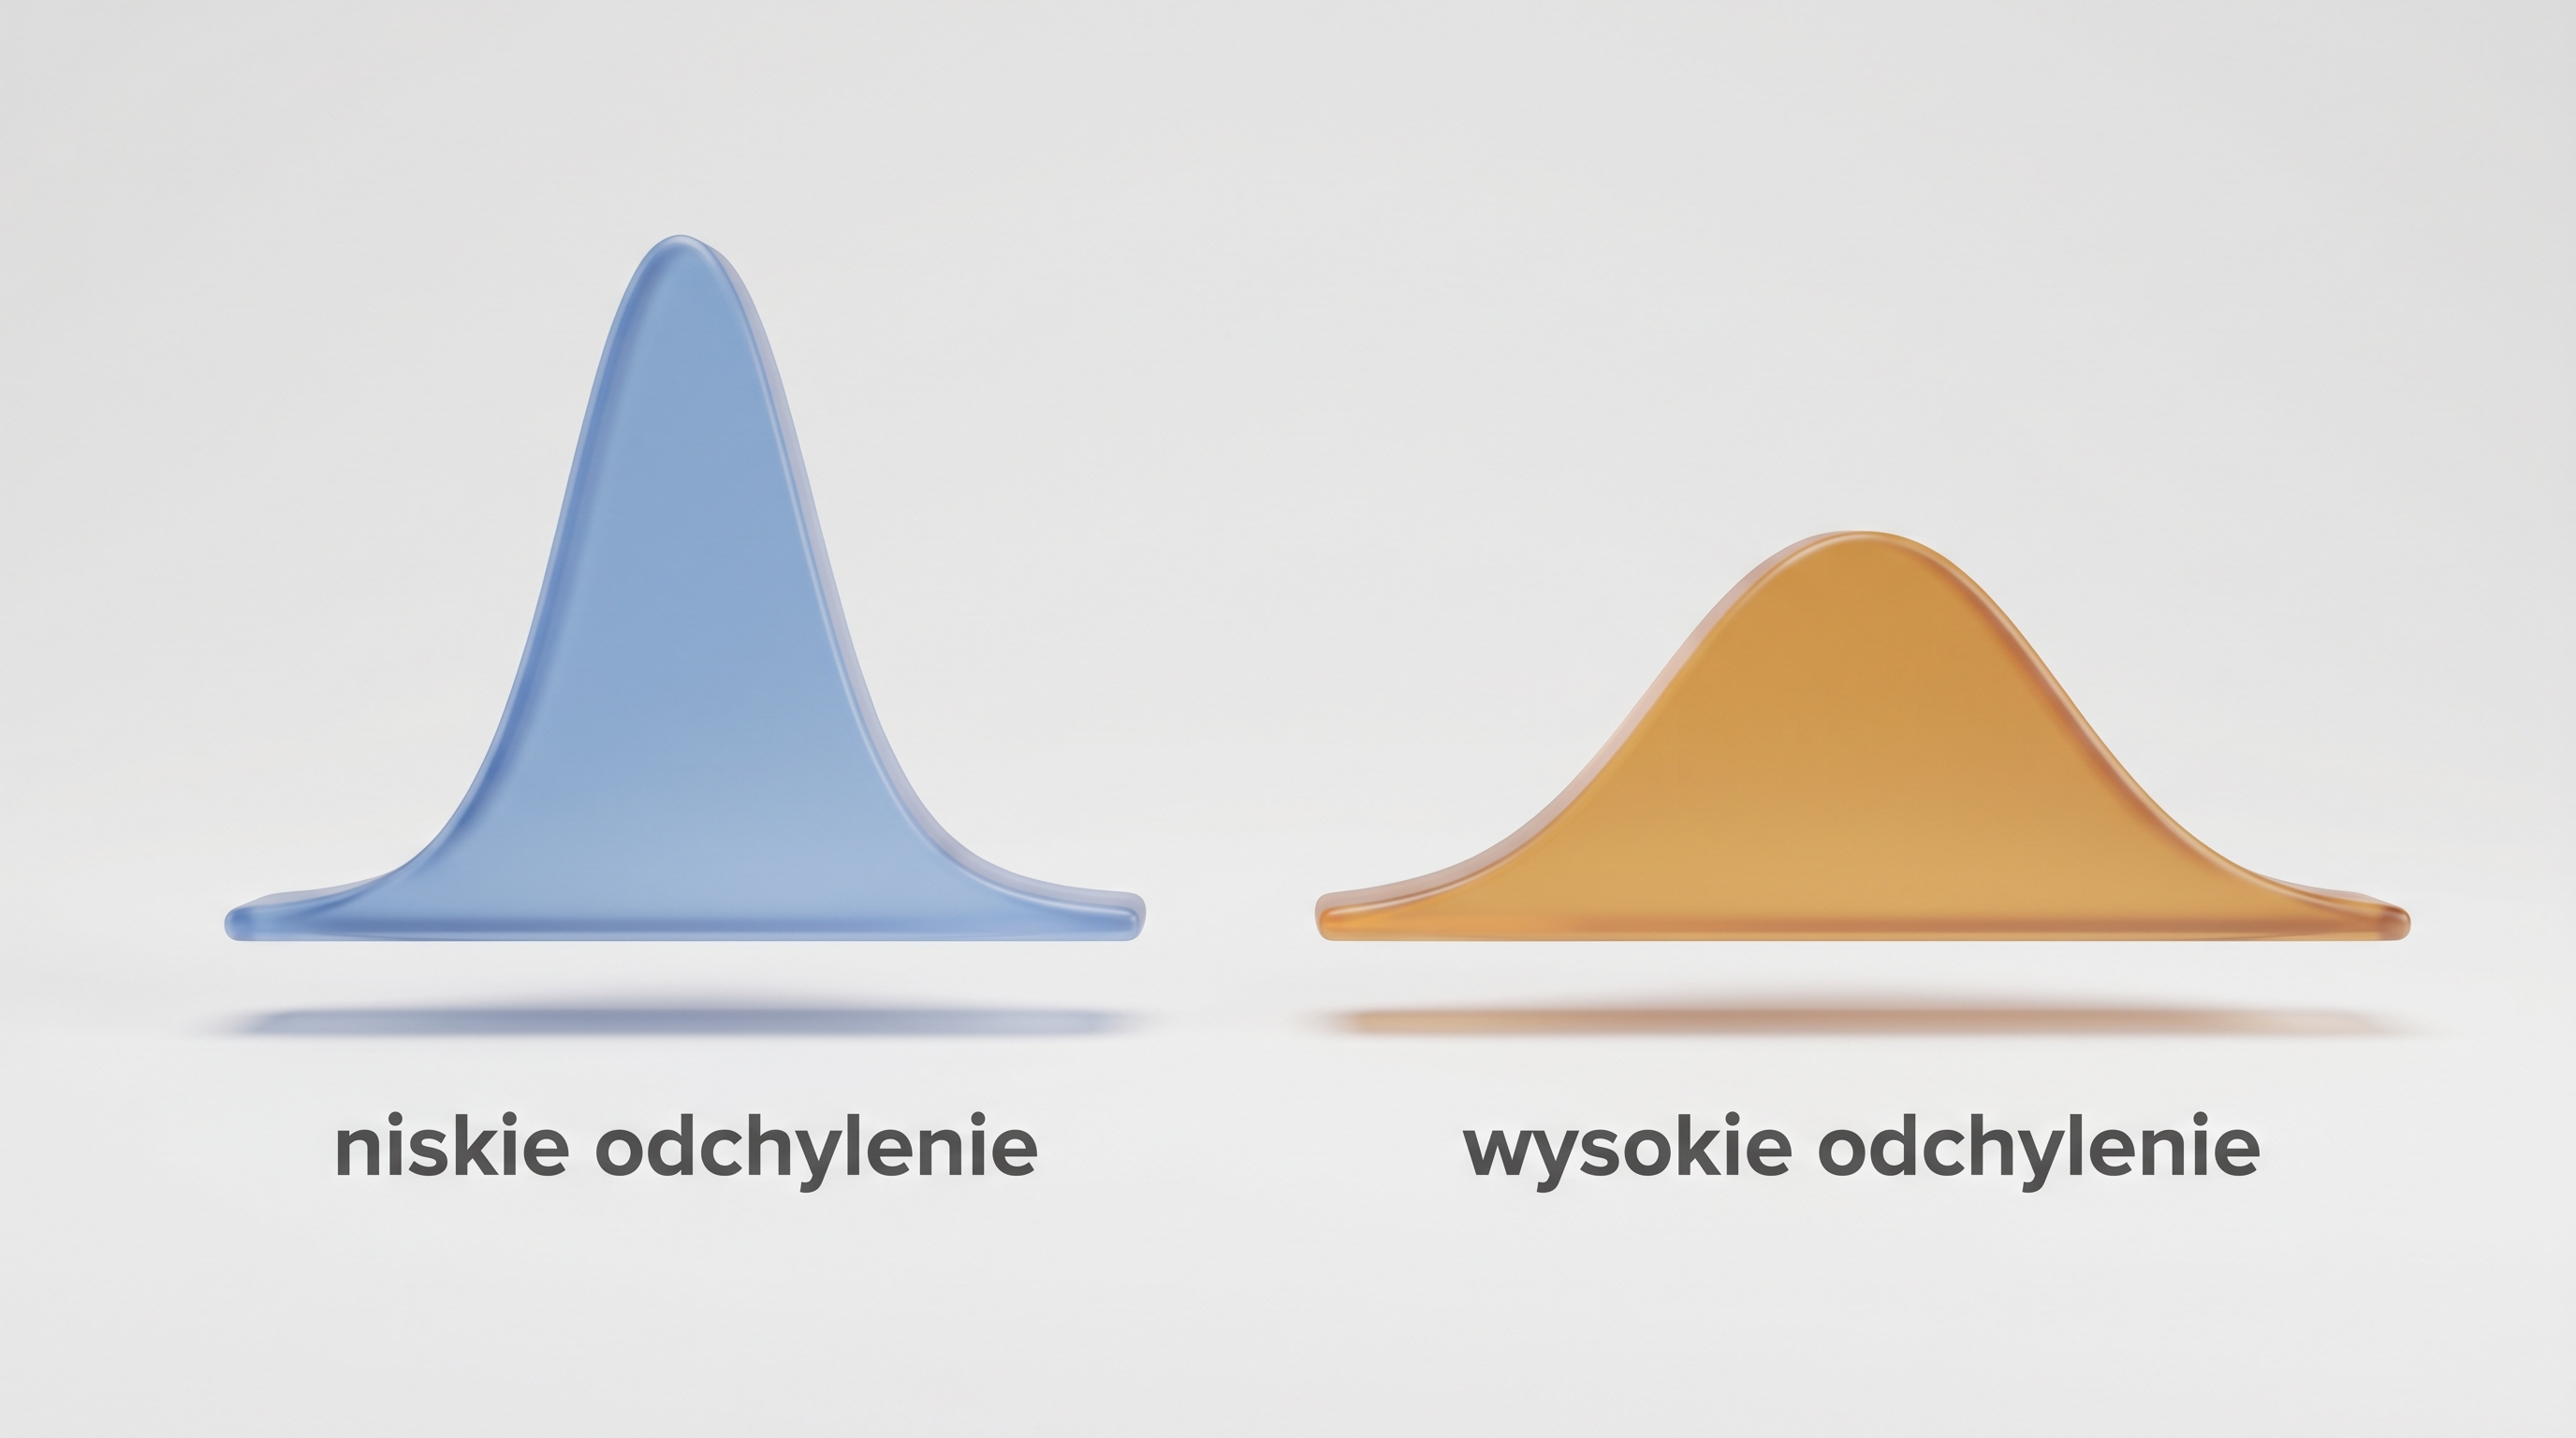
Zastanawiałeś się kiedyś, dlaczego niektóre zestawy danych są bardzo przewidywalne, a inne zachowują się jak dziki mustang? Właśnie do mierzenia tego „rozrzutu” służy odchylenie standardowe excel. Mówiąc wprost: odchylenie standardowe mówi ci, jak bardzo poszczególne wartości w zbiorze różnią się od średniej. Małe odchylenie oznacza, że dane są skupione wokół średniej. Duże – że tworzą szeroki wachlarz wyników, od bardzo niskich po bardzo wysokie.
Wyobraź sobie, że analizujesz miesięczne wydatki dwóch kawiarni. W pierwszej każdy dzień wygląda podobnie: rachunki oscylują wokół 2000 zł. W drugiej są dni z utargiem 500 zł i takie z wynikiem 5000 zł. Odchylenie standardowe od razu wskaże, która kawiarnia ma stabilniejsze przychody. I właśnie do takich obliczeń przydaje się Excel.
Definicja odchylenia standardowego – prostym językiem
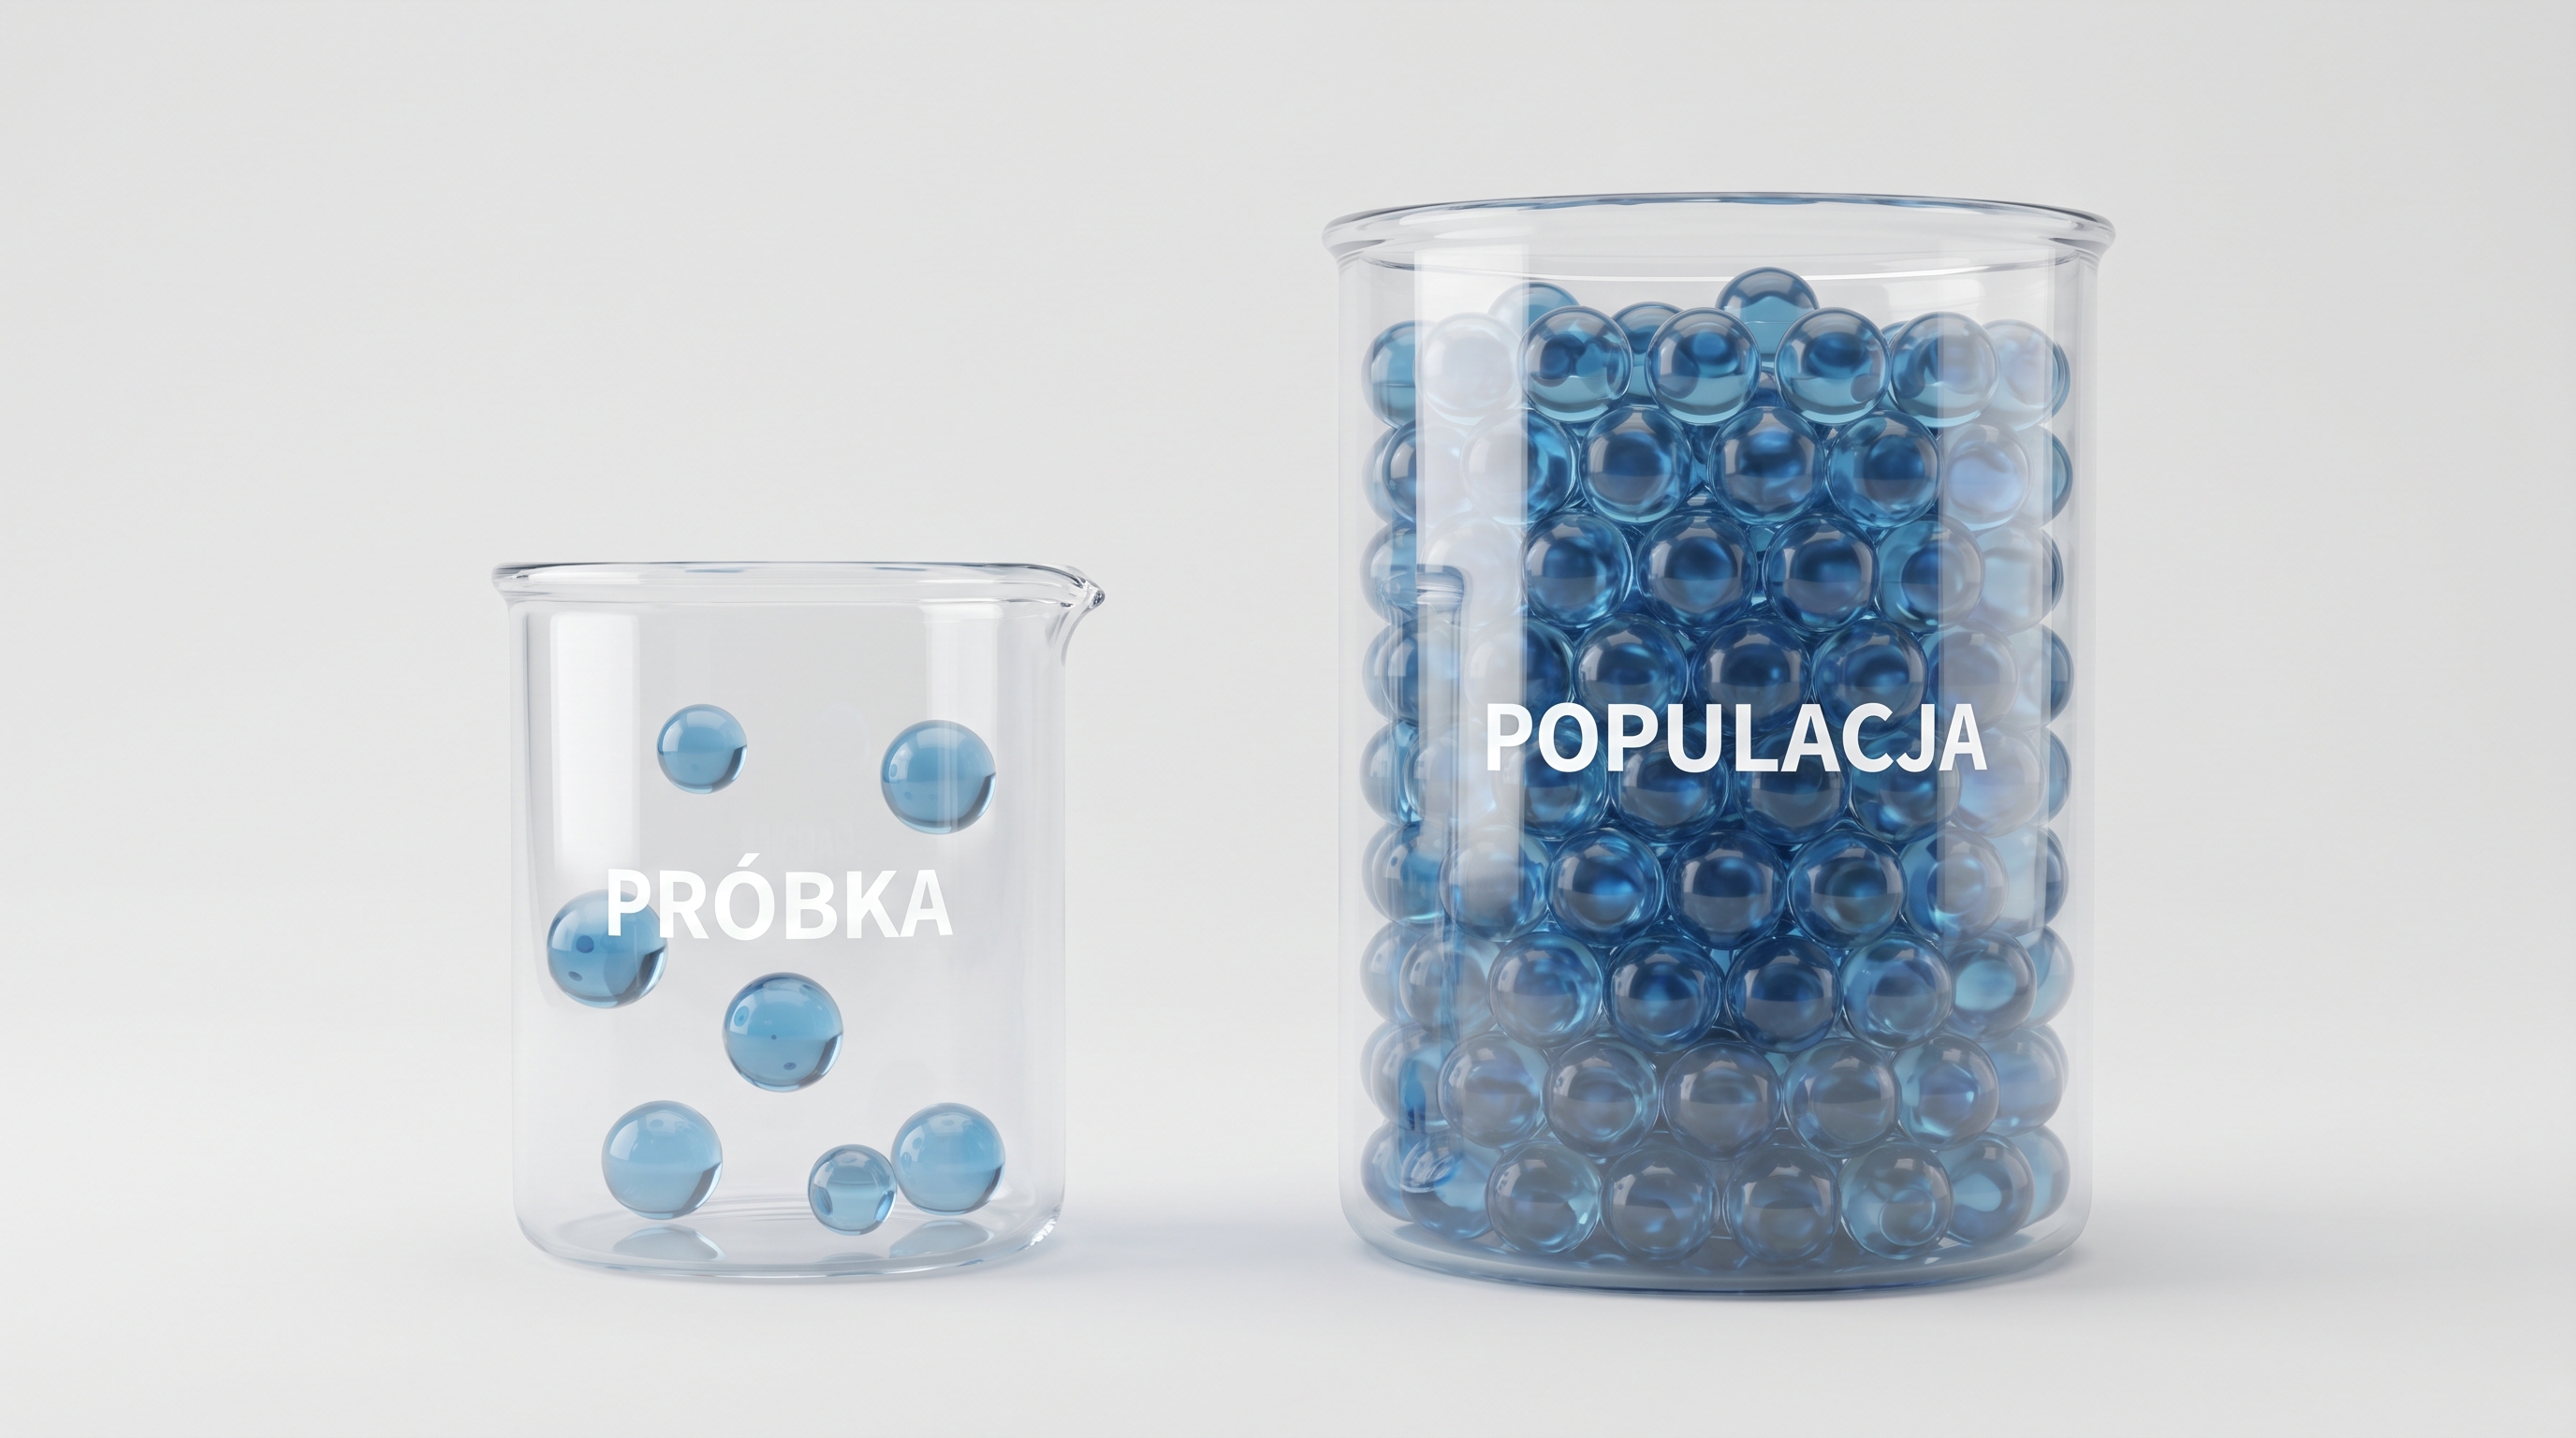
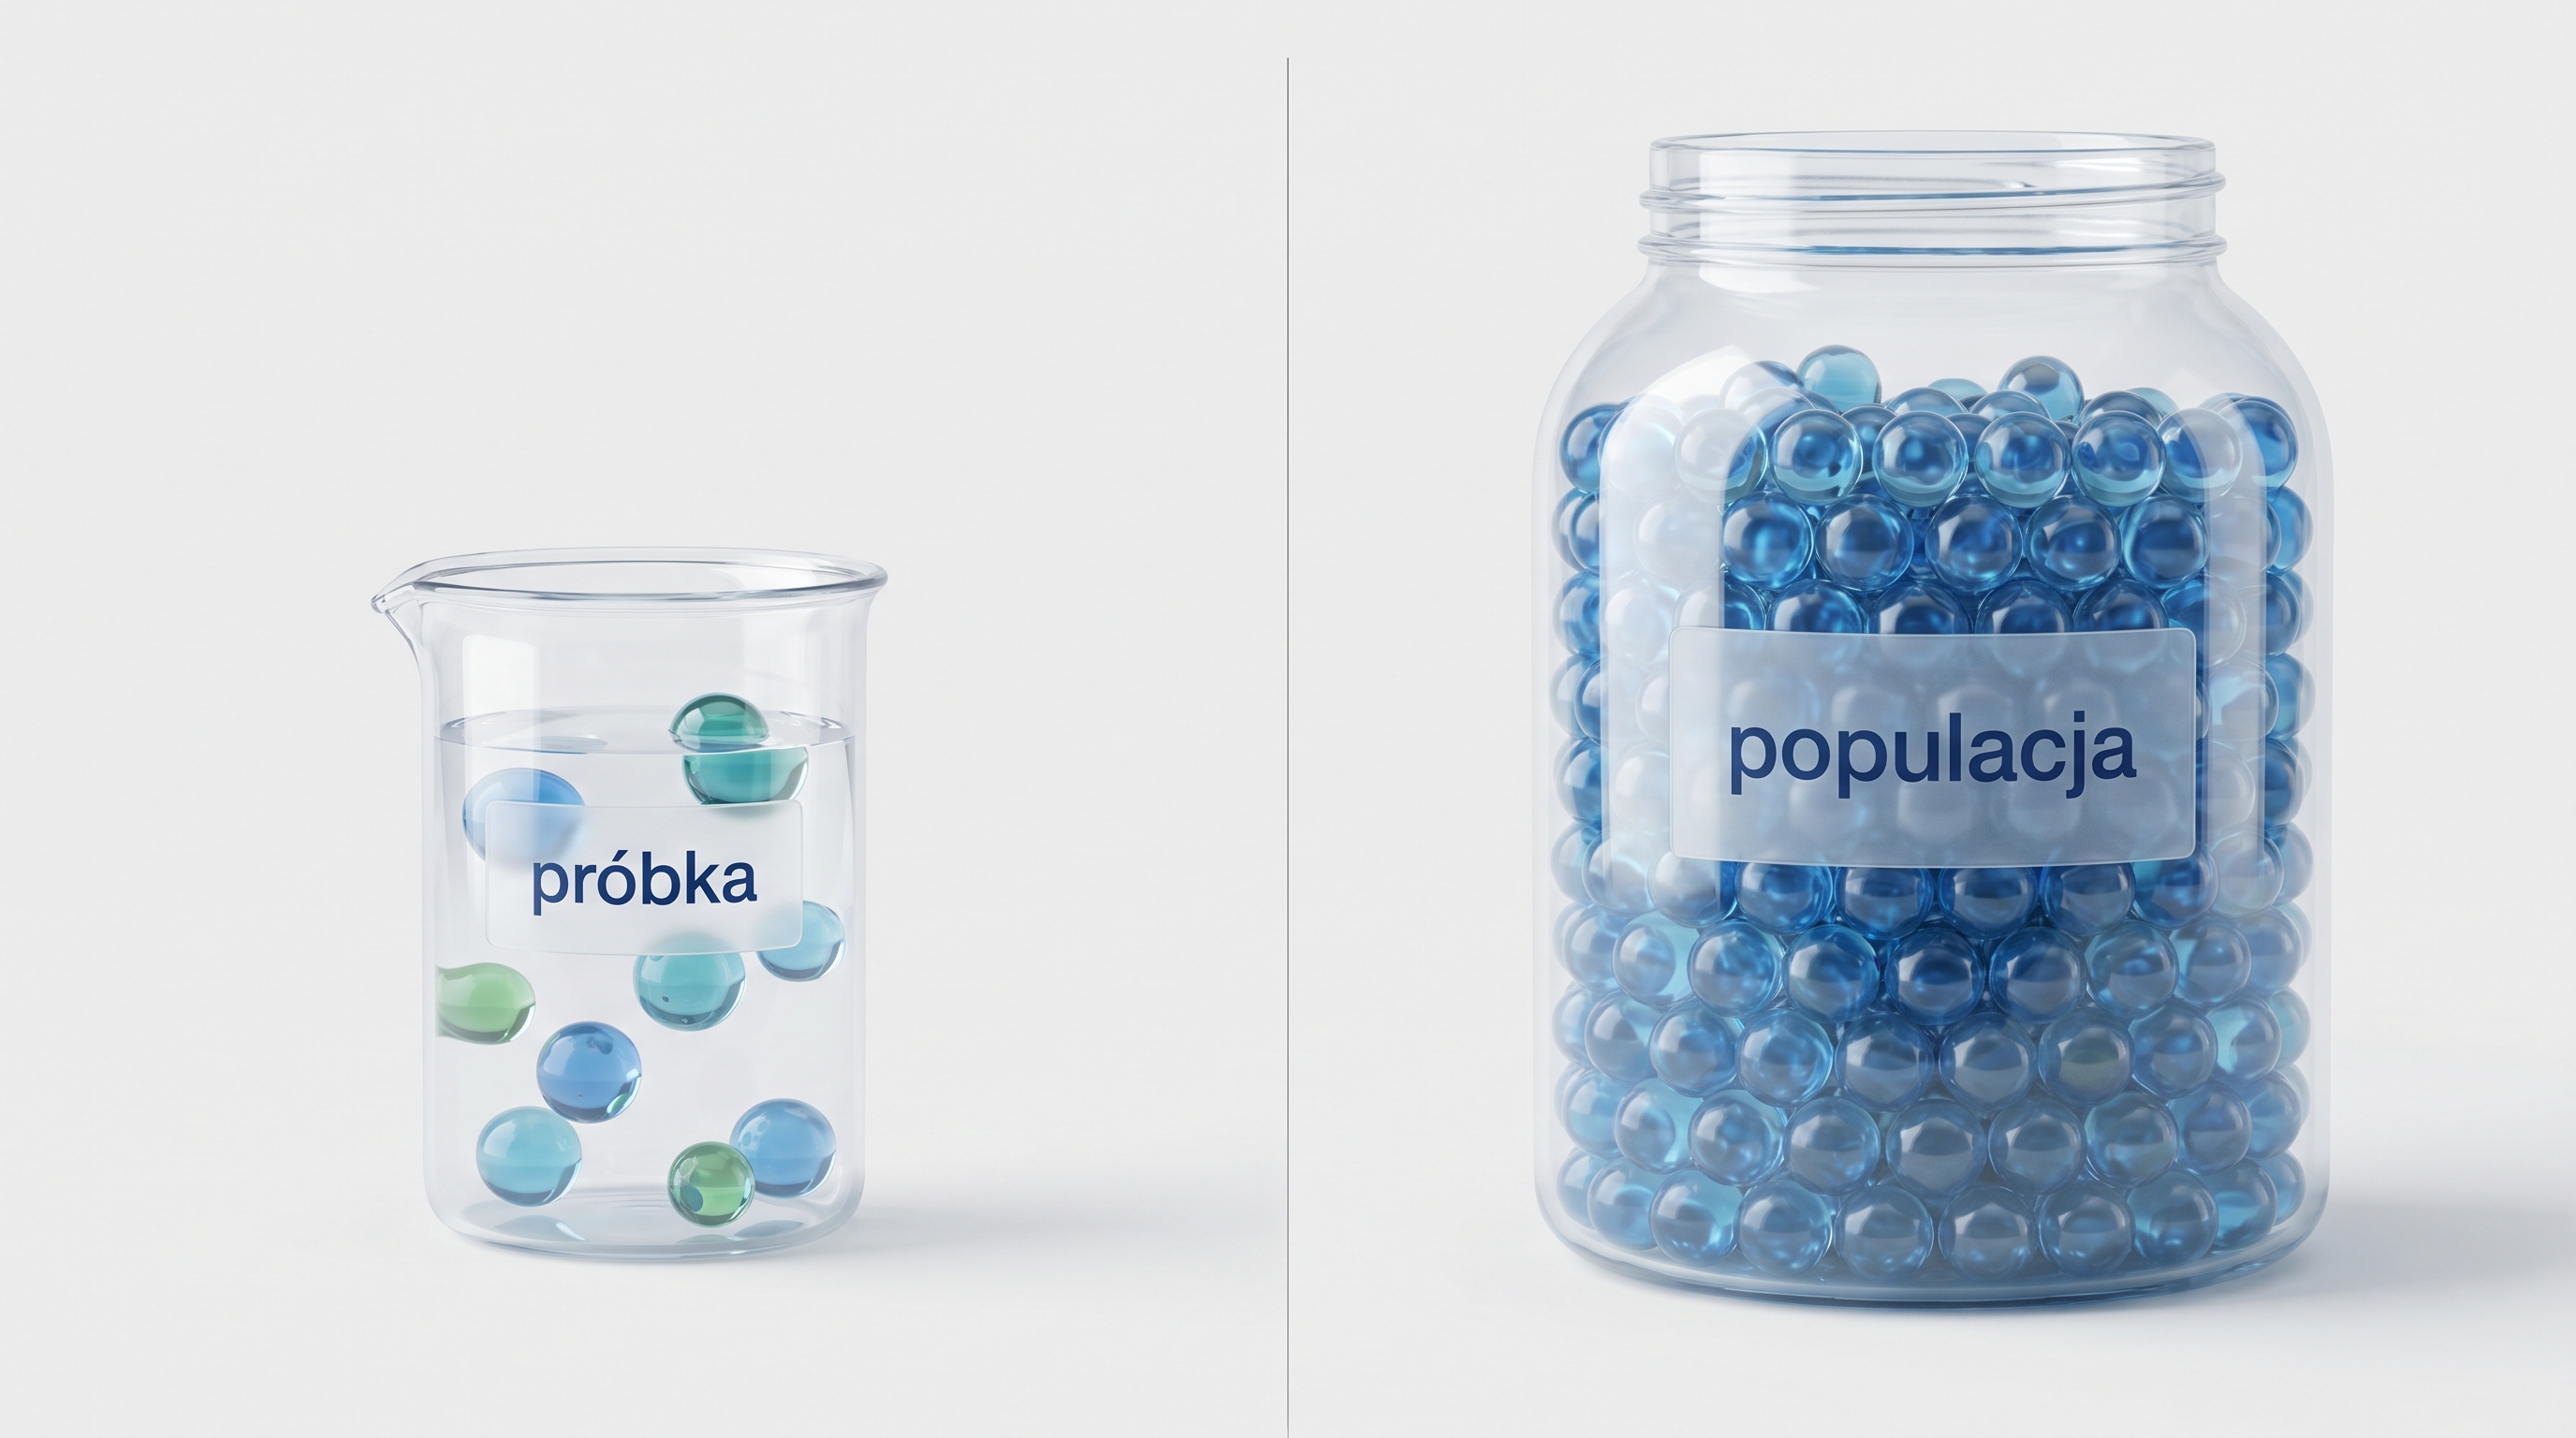
Formalnie odchylenie standardowe to pierwiastek kwadratowy z wariancji. Ale bez paniki – nie musisz tego liczyć ręcznie. W Excelu robi to za ciebie kilka funkcji. Kluczowa różnica między nimi sprowadza się do jednego pytania: czy twoje dane to próbka, czy cała populacja?
Jeśli mierzysz wzrost wszystkich uczniów w jednej klasie (i tylko tej klasy cię interesuje), pracujesz na całej populacji. Jeśli mierzysz wzrost 30 losowo wybranych uczniów, by wnioskować o wszystkich uczniach w szkole – pracujesz na próbce. To rozróżnienie ma znaczenie przy wyborze funkcji w Excelu.
Jakie funkcje Excela służą do obliczania odchylenia standardowego?
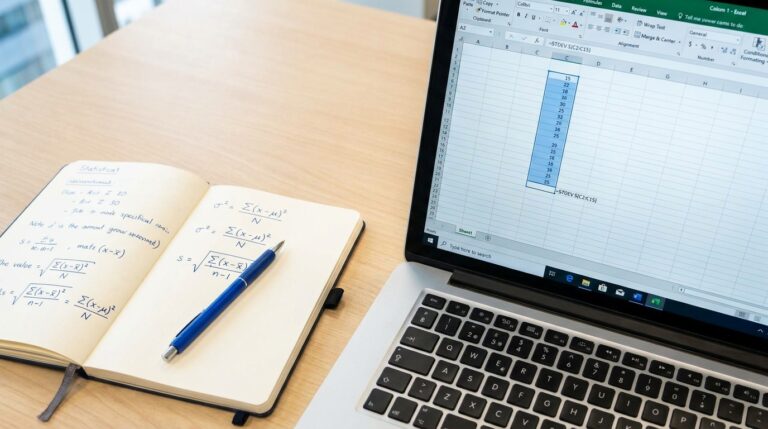
Excel oferuje kilka funkcji do tego zadania, ale w praktyce najczęściej korzystasz z dwóch. Funkcja ODCH.STANDARD.PRÓBKI (w wersji angielskiej: STDEV.S) przeznaczona jest do danych, które stanowią próbkę populacji. Używa wzoru √[∑(x – x̃)²/(n-1)](1). Z kolei funkcja ODCH.STANDARD.POPUL.A (ang. STDEV.P) służy do danych obejmujących całą populację i stosuje wzór √[∑(x – x̃)²/n](2).
Dlaczego jeden wzór dzieli przez n-1, a drugi przez n? To poprawka Bessela. Gdy pracujesz na próbce, nie znasz pełnego obrazu populacji. Dzieląc przez n-1 zamiast n, nieznacznie zawyżasz odchylenie – to twoje zabezpieczenie przed zbyt optymistycznym wnioskowaniem. W praktyce oznacza to, że odchylenie standardowe populacji będzie zawsze mniejsze niż odchylenie standardowe próbki dla tych samych danych liczbowych.
Składnia funkcji ODCH.STANDARD.PRÓBKI i ODCH.STANDARD.POPUL.A
Składnia obu funkcji jest identyczna i banalnie prosta:
=ODCH.STANDARD.PRÓBKI(liczba1; [liczba2]; …)
=ODCH.STANDARD.POPUL.A(liczba1; [liczba2]; …)
Parametry:
– liczba1 – pierwsza liczba, zakres komórek lub tablica (wymagany).
– liczba2 – kolejne liczby lub zakresy (opcjonalne, maksymalnie 254 argumenty).
W praktyce najczęściej podajesz po prostu zakres komórek. Jeśli twoje dane znajdują się w komórkach od A1 do A20, wpisujesz:
=ODCH.STANDARD.PRÓBKI(A1:A20)
Funkcja automatycznie pomija puste komórki i tekst – analizuje wyłącznie wartości liczbowe. Dzięki temu możesz trzymać dane z nagłówkami w tym samym arkuszu bez obaw o błędne wyniki. Jeśli potrzebujesz uwzględnić w obliczeniach wartości logiczne (PRAWDA/FAŁSZ) lub tekstowe reprezentacje liczb, dodaj na końcu nazwy funkcji literę A – np. ODCH.STANDARD.POPUL.A zawiera już tę opcję w swoim oznaczeniu.
ODCH.STANDARD.PRÓBKI czy ODCH.STANDARD.POPUL.A – którą funkcję wybrać?
Wybór między tymi dwiema funkcjami sprowadza się do jednego pytania: czy twoje dane to próbka, czy cała populacja? To najczęstszy punkt zapalny dla początkujących użytkowników Excela. Źle dobrana funkcja nie popsuje obliczeń, ale da wynik, który może cię wprowadzić w błąd. Sprawdźmy więc, jak podjąć dobrą decyzję.
Kiedy dane stanowią próbkę, a kiedy całą populację?
Populacja to kompletny zbiór wszystkich elementów, które cię interesują. Jeśli analizujesz wyniki egzaminu ósmoklasisty we wszystkich szkołach w Polsce w 2024 roku – to jest twoja populacja. Masz wtedy dane każdego ucznia i nie potrzebujesz uogólniać na nikogo innego.
Próbka to podzbiór populacji. Wyciągasz z niej wnioski o całej grupie. Na przykład: mierzysz czas reakcji 200 kierowców, by oszacować średni czas reakcji wszystkich kierowców w kraju. Nie możesz przebadać 20 milionów ludzi, więc robisz test na reprezentatywnej grupie. Twoje 200 pomiarów to właśnie próbka. I tu wchodzi ODCH.STANDARD.PRÓBKI.
Różnice we wzorach: dzielenie przez n vs n-1 (poprawka Bessela)
Matematyczna różnica między tymi funkcjami jest prosta, ale ma poważne konsekwencje. Funkcja ODCH.STANDARD.POPUL.A dzieli sumę kwadratów odchyleń przez n (liczbę wszystkich obserwacji). Natomiast ODCH.STANDARD.PRÓBKI dzieli przez n-1, gdzie n to liczebność próbki.
Dlaczego odejmujemy jedynkę? Bo próbka z definicji nie obejmuje całej populacji, więc jej wariancja jest nieco zaniżona. Poprawka Bessela (dzielenie przez n-1) kompensuje to niedoszacowanie. Efekt? Dla tych samych danych liczbowych odchylenie standardowe populacji będzie zawsze mniejsze niż odchylenie standardowe próbki(3). Różnica maleje wraz ze wzrostem próbki – przy 1000 obserwacji dzielenie przez 999 zamiast 1000 zmienia wynik marginalnie, ale przy 10 pomiarach robi już znaczącą różnicę.
Tabela porównawcza: ODCH.STANDARD.PRÓBKI vs ODCH.STANDARD.POPUL.A
| Cecha | ODCH.STANDARD.PRÓBKI (STDEV.S) | ODCH.STANDARD.POPUL.A (STDEV.P) |
|---|---|---|
| Nazwa angielska | STDEV.S | STDEV.P |
| Przeznaczenie | Dane stanowiące próbkę populacji | Dane obejmujące całą populację |
| Wzór | √[∑(x – x̃)²/(n-1)] | √[∑(x – x̃)²/n] |
| Mianownik | n-1 (poprawka Bessela) | n |
| Wynik | Wyższy (ostrożniejsze oszacowanie) | Niższy (dokładny dla populacji) |
| Starszy odpowiednik | STDEV (identyczny wynik)(4) | STDEVP (identyczny wynik)(4) |
| Kiedy stosować? | Analiza ankiet, badań rynkowych, testów | Spisy powszechne, dane z całego systemu |
Przykład liczbowy krok po kroku w Excelu
Masz pomiary czasu realizacji (w minutach) dla 5 zamówień w magazynie: 12, 15, 11, 18, 14. To twoja próbka – chcesz na jej podstawie ocenić zmienność wszystkich zamówień.
Krok 1: Wpisz dane do komórek A1:A5: 12, 15, 11, 18, 14.
Krok 2: W komórce B1 wpisz formułę dla próbki:
=ODCH.STANDARD.PRÓBKI(A1:A5)
Wynik: 2,74
Krok 3: W komórce B2 wpisz formułę dla populacji:
=ODCH.STANDARD.POPUL.A(A1:A5)
Wynik: 2,45
Wniosek: Różnica wynosi 0,29, co przy zaledwie 5 obserwacjach jest znaczące. Gdybyś błędnie użył funkcji dla populacji, sztucznie zaniżyłbyś odchylenie, co mogłoby prowadzić do zbyt optymistycznych wniosków o stabilności procesu magazynowego.
Jeśli pracujesz na starszych plikach Excela, możesz spotkać funkcje STDEV i STDEVP. STDEV daje identyczny wynik co STDEV.S, a STDEVP – co STDEV.P(4). To relikt dawnych wersji, ale nadziała – jeśli widzisz je w cudzym arkuszu, wiesz już, co oznaczają.
Jak interpretować wyniki odchylenia standardowego w praktyce?
Sam wynik liczbowy to dopiero połowa sukcesu. Prawdziwa wartość odchylenia standardowego ujawnia się, gdy potrafisz go odczytać i przełożyć na konkretne wnioski. Wynik informuje o tym, jak bardzo poszczególne wartości różnią się od średniej – im większe odchylenie standardowe, tym większy rozrzut wyników(5). Ale co to oznacza w twojej codziennej pracy?
Co oznacza niskie, a co wysokie odchylenie standardowe?
Niskie odchylenie standardowe to sygnał, że twoje dane są stabilne i przewidywalne. Przykład: codzienna liczba klientów w osiedlowym sklepie spożywczym oscyluje między 95 a 105 osobami, a średnia wynosi 100. Odchylenie standardowe na poziomie 3 oznacza, że większość dni nie odbiega znacząco od normy. Możesz z wyprzedzeniem planować zatowarowanie i liczbę pracowników na zmianie.
Wysokie odchylenie standardowe z kolei mówi: uwaga, dane są chaotyczne. Jeśli ten sam sklep notuje dni z 20 klientami i dni z 300 klientami, odchylenie standardowe skoczy do kilkudziesięciu. Planowanie staje się trudniejsze – musisz mieć bufor zarówno na personel, jak i na zapasy. Wysokie odchylenie nie jest samo w sobie złe – to po prostu informacja, że potrzebujesz elastyczniejszych procesów.
Zastosowanie odchylenia standardowego w finansach, HR i analizie sprzedaży
W finansach odchylenie standardowe to podstawa oceny ryzyka. Im wyższe odchylenie miesięcznych stóp zwrotu funduszu inwestycyjnego, tym bardziej zmienne są jego wyniki. Fundusz akcyjny może mieć odchylenie na poziomie 15–20% w skali roku, podczas gdy fundusz obligacji skarbowych – zaledwie 2–3%. Jeśli jesteś inwestorem o niskiej tolerancji ryzyka, wybierzesz ten drugi, nawet jeśli średnie stopy zwrotu są niższe.
W HR odchylenie standardowe pomaga analizować rozkład wynagrodzeń w firmie. Niskie odchylenie oznacza, że wszyscy na podobnych stanowiskach zarabiają zbliżone kwoty – polityka płacowa jest spójna. Wysokie odchylenie może świadczyć o problemach: nierównościach, wypłacaniu premii uznaniowych bez jasnych kryteriów lub o rozjeździe stawek rynkowych w różnych działach.
W analizie sprzedaży odchylenie standardowe dziennych transakcji powie ci, czy twój biznes działa stabilnie przez cały miesiąc, czy raczej żyje od promocji do promocji. Przykład: sklep internetowy notuje średnio 200 zamówień dziennie. Jeśli odchylenie wynosi 15 – codzienność jest przewidywalna. Jeśli odchylenie wynosi 80 – oznacza to potężne skoki popytu, które wymagają elastycznego łańcucha dostaw.
Najczęstsze błędy przy interpretacji wyników
Błąd #1: Porównywanie odchyleń standardowych z różnych skal. Odchylenie 5 zł dla ceny kawy w kawiarni to dużo. Odchylenie 5 zł dla ceny samochodu to tyle, co nic. Zawsze odnoś wynik do skali swoich danych i średniej. Praktyczną miarą jest współczynnik zmienności – odchylenie standardowe podzielone przez średnią, wyrażone w procentach.
Błąd #2: Zakładanie, że dane mają rozkład normalny. Odchylenie standardowe najlepiej interpretować, gdy dane układają się w klasyczną krzywą dzwonową (rozkład Gaussa). Jeśli masz dane z grubymi ogonami (jak ceny akcji w czasie krachu) lub silnie skośne (jak dochody w populacji), samo odchylenie może być mylące. W takich przypadkach uzupełnij analizę o mediana i kwartyle.
Błąd #3: Ignorowanie spójności jednostek. Jeśli liczysz odchylenie dla dziennych przychodów w złotych, wynik też jest w złotych. Brzmi banalnie, ale łatwo o pomyłkę, gdy porównujesz ze sobą różne zestawy danych – na przykład odchylenie dziennych obrotów w euro z odchyleniem miesięcznych zysków w złotych. Zawsze ujednolicaj jednostki przed porównaniem.
Najczęściej zadawane pytania (FAQ)
Jaka jest różnica między STDEV. S a STDEV. P w Excelu?
STDEV. S (ODCH. STANDARD. PRÓBKI) oblicza odchylenie standardowe dla próbki danych, dzieląc przez n-1. STDEV. P (ODCH. STANDARD. POPUL. A) oblicza odchylenie dla całej populacji, dzieląc przez n. Różnica polega na mianowniku – poprawka Bessela w STDEV. S sprawia, że wynik jest nieco wyższy, co daje bezpieczniejsze oszacowanie dla danych próbkowych.
Kiedy używać ODCH. STANDARD. PRÓBKI zamiast ODCH. STANDARD. POPUL. A?
ODCH. STANDARD. PRÓBKI używaj, gdy twoje dane stanowią podzbiór większej populacji i chcesz na ich podstawie wnioskować o całej grupie. ODCH. STANDARD. POPUL. A stosuj, gdy masz kompletne dane obejmujące wszystkie elementy badanej populacji i nie potrzebujesz uogólniać wyników.
Czy STDEV i STDEV. S to to samo?
Tak, STDEV i STDEV. S (w polskiej wersji: ODCH. STANDARD. PRÓBKI) zwracają identyczne wyniki. Funkcja STDEV została zachowana w Excelu dla zgodności ze starszymi wersjami. Podobnie STDEVP daje ten sam wynik co STDEV. P (ODCH. STANDARD. POPUL. A). W nowszych arkuszach zaleca się używanie nowszych wersji STDEV. S i STDEV. P.
Jak obliczyć odchylenie standardowe w Excelu krok po kroku?
Wprowadź swoje dane liczbowe do jednej kolumny, na przykład od A1 do A20. W pustej komórce wpisz formułę =ODCH. STANDARD. PRÓBKI(A1: A20) i zatwierdź klawiszem Enter. Excel automatycznie obliczy odchylenie standardowe dla podanego zakresu. Jeśli potrzebujesz odchylenia dla całej populacji, użyj =ODCH. STANDARD. POPUL. A(A1: A20).
Dlaczego odchylenie standardowe populacji jest mniejsze niż próbki?
Dzieje się tak, ponieważ wzór na odchylenie populacji dzieli sumę kwadratów odchyleń przez n (liczbę wszystkich obserwacji), podczas gdy wzór na próbkę dzieli przez n-1. Poprawka Bessela kompensuje fakt, że próbka nie obejmuje całej populacji i jej wariancja jest nieco zaniżona. W efekcie wynik dla próbki jest zawsze wyższy niż dla populacji przy tych samych danych liczbowych.
Źródła
- https://learn.microsoft.com/pl-pl/dax/stdev-s-function-dax
- https://learn.microsoft.com/pl-pl/dax/stdev-p-function-dax
- https://statorials.org/pl/stdevp-vs-stdevs-w-programie-excel/
- https://standarddeviationcalculator.app/pl/learn/excel-python
- https://calculatic.pl/poradnik/excel-odchylenie-standardowe/